Guiar un rebaño con un perro que solo repele
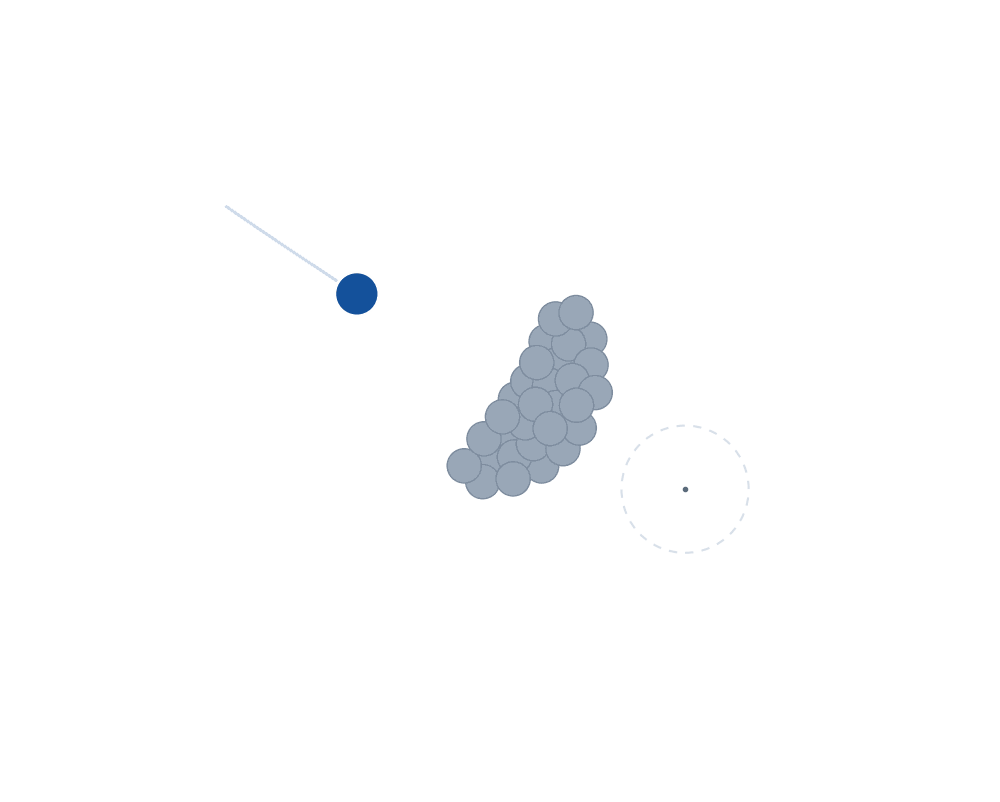
Un pastor no tira de sus ovejas: las asusta. Toda la fuerza que puede aplicar es repulsiva, y aun así el rebaño acaba donde él quiere. Esto es ese problema montado como dinámica de partículas en LAMMPS: el modelo, la validación contra un número cerrado, y el punto exacto en el que la estrategia del perro deja de funcionar.
Lectura rápida
- Qué se simula. Un perro y 30 ovejas, puntos con masa unidad en el plano, con
fuerzas radiales y rozamiento. 900 unidades de tiempo con paso 0,01, en LAMMPS
(
dimension 2,units lj). El modelo y la política son los del TFM de 2020. - Lo raro del modelo. El perro repele a las ovejas, pero no siente su reacción: es
una interacción asimétrica, que viola la tercera ley de Newton. Por eso no puede
ser un
pair_stylede LAMMPS y va confix addforce. - La estrategia. Dos términos: uno coloca al perro a distancia fija del rebaño y otro lo hace girar hasta ponerse detrás, en la línea que une rebaño y objetivo. Solo necesita saber dónde está el centro del rebaño.
- Antes del resultado, la referencia. El caso de un perro y una oveja tiene solución
asintótica analítica: acaban viajando en línea recta separados
√2a velocidad1/√2. LAMMPS la reproduce con error 3·10⁻¹². - Qué sale. El rebaño parte a 202 del objetivo y llega (distancia < 20) en t = 400, con la dispersión bajando de 1006 a 418: el perro conduce y además agrupa. Pero no se para: el sistema acaba en un ciclo límite, con el perro orbitando el rebaño cada ≈ 58 unidades de tiempo y el centro del rebaño dando vueltas a 3,3 del objetivo. Es el comportamiento que reporta el TFM.
- Qué no demuestra. Una ejecución, una semilla, una condición inicial. La heurística no es óptima ni estable, y aquí no se compara con nada mejor.
- Se puede repetir. Un
run.shque genera las tablas, lanza los tres ensayos de LAMMPS, comprueba las fuerzas y exporta la animación de esta página.
El problema: conducir empujando
El pastoreo es un problema de control con una restricción incómoda. Hay un agente que se controla —el perro— y muchos que no —las ovejas—, y el único canal entre ellos es una fuerza repulsiva: el perro puede alejar a una oveja, nunca acercarla. Para llevar el rebaño hacia un sitio hay que colocarse en el lado contrario y empujar; y como las ovejas huyen de donde el perro está, no de donde quiere llevarlas, el control es indirecto en el peor sentido: cada corrección exige antes reposicionarse.
En la literatura esto se llama guidance by repulsion, y Escobedo, Ibáñez y Zuazua lo formularon en 2016 con el caso mínimo: un conductor y un evasor. Es un juguete que tiene todo lo que hace falta —asimetría, disipación y una solución asintótica cerrada— y, por eso mismo, es el banco de pruebas de este artículo. El salto a un rebaño de 30 añade lo que al caso mínimo le falta: cohesión entre ovejas, un centro de masas que se puede medir y una estrategia que decidir.
Lo que sigue no es un trabajo nuevo de investigación: es el modelo del TFM llevado a LAMMPS, que es un motor pensado para átomos, y comprobado paso a paso. La pregunta práctica que contesta es si una herramienta de dinámica molecular sirve para un modelo de agentes con interacciones que no son newtonianas. Sirve, con dos adaptaciones que son la mitad interesante del asunto.
El modelo: tres fuerzas y una decisión
Cada individuo es un punto con masa unidad en el plano. Todas las interacciones son radiales: dependen solo de la distancia y actúan en la línea que une a los dos individuos. Con masa unidad, fuerza y aceleración son el mismo número, que es la convención del modelo original.
| Interacción | Fuerza | Qué hace |
|---|---|---|
| oveja–oveja | g_oo(r) = −(1/r − 1/r_min_o) |
atrae de lejos, repele de cerca: el rebaño se junta pero no se apelmaza |
| perro → oveja | g_op(r) = −F_m · exp(−r²/σ²) |
siempre repulsiva, con alcance σ |
| perro–perro | g_pp(r) = −(1/r − 1/r_min_p) |
evita que dos perros choquen (aquí solo hay uno) |
El convenio de signos es el del TFM: la aceleración sobre el individuo i debida a k es
g(r)·(u_k − u_i)/|u_k − u_i|, de modo que g > 0 atrae hacia k y g < 0 lo repele. La
primera fuerza tiene un punto de equilibrio en r = r_min_o: dos ovejas más juntas que
eso se separan, más lejos se buscan. Es lo que hace que un montón de puntos se comporte
como un rebaño y no como un gas.
La dinámica es de segundo orden con rozamiento:
u̇_o = v_o     v̇_o = −ν_o v_o + G_oo + G_op
u̇_p = v_p     v̇_p = −ν_p v_p + G_pp + a
Ese a del final es todo el problema. Es la acción del perro, la única variable de
control del sistema, y hay que decidir qué vale en cada instante. El rozamiento no es un
adorno: con ν_o = 0,45 y ν_p = 5 el sistema es fuertemente disipativo, las velocidades
se olvidan rápido y lo que manda es la posición relativa. El perro, con un rozamiento diez
veces mayor, es ágil: para y arranca casi al instante.
«Empujar y girar»
La heurística del TFM no necesita saber dónde está cada oveja, solo la posición media
del rebaño u_om. Son dos términos:
a = h_r(r) (u_om − u_d) + h_p(φ) (u_d − u_om)^⊥

h_r(r) = −1/r + 1/r_pos          r = |u_d − u_om|
h_p(φ) = 1 − cos φ               φ = ángulo entre (u_om − u_T) y (u_d − u_om)
El primer término es radial: lleva al perro a una distancia fija r_pos del centro del
rebaño, acercándolo si está lejos y apartándolo si se ha metido dentro. El segundo es
tangencial: lo hace girar alrededor del rebaño. Y el factor que lo gobierna, 1 − cos φ,
es el que hace que la cosa funcione, porque φ mide el ángulo entre «hacia dónde hay que
llevar el rebaño» y «dónde está el perro respecto al rebaño». Cuando el perro ya está
detrás —en la línea que une rebaño y objetivo, por el lado contrario— ese ángulo es cero,
el término tangencial se apaga y el perro deja de girar: solo empuja.
Es una política de dos frases, sin ningún estado interno, y con una propiedad que conviene no perder de vista: no mira al objetivo para empujar, solo para orientarse. El empujón es un efecto colateral de estar cerca. Esto se nota al final, y es de lo que trata la sección «Qué sale».
Los parámetros, y de dónde sale cada uno
| Parámetro | Valor | De dónde sale |
|---|---|---|
r_min_o (equilibrio oveja–oveja) |
30 | TFM, figura 5 |
r_min_p (perro–perro) |
10 | TFM, figura 5 |
σ (alcance de la repulsión del perro) |
50 | TFM, figura 5 |
F_m (intensidad de la repulsión) |
5 | calibrado aquí; la figura 5 del TFM sugiere ≈ 7 |
ν_o (rozamiento de las ovejas) |
0,45 | código original en MATLAB |
ν_p (rozamiento del perro) |
5 | ídem |
r_pos (distancia perro–rebaño) |
45 | calibrado aquí, ver abajo |
| ganancia de la política | 2,5 | calibrado aquí |
| ovejas | 30 | |
| paso de tiempo | 0,01 |
Tres de esos valores son míos y no del modelo, y es importante que se vea cuáles: con otros, la misma política puede dispersar el rebaño en vez de conducirlo.
Cómo se monta en LAMMPS, y qué hubo que adaptar
LAMMPS está hecho para átomos, pero nada de su motor exige que lo sean: hay partículas puntuales, fuerzas que dependen de la distancia, un integrador y amortiguamiento. Las piezas se corresponden casi una a una:
| Del modelo | En LAMMPS | Diferencia |
|---|---|---|
g_oo entre ovejas |
pair_style table con una tabla generada en Python |
interpolación: 0,18 % de error relativo |
g_op del perro sobre las ovejas |
fix addforce con variables que leen la posición del perro por su ID |
ninguna: se evalúa la fórmula, error ~10⁻¹⁵ |
rozamiento −ν v |
fix viscous |
ninguna |
| política del perro | compute com + variables + fix addforce |
ninguna |
| integración RK4 | velocity-Verlet (fix nve) |
orden 2 en vez de 4 |
Dos decisiones merecen explicación, y son las que convierten esto en un tutorial y no en una receta.
La repulsión del perro no puede ser un pair_style. En el modelo, el perro repele a
las ovejas pero no siente la reacción: en su ecuación solo aparecen la interacción con
otros perros y su propia acción. Eso viola la tercera ley de Newton —los autores del
modelo original lo llaman «anti-newtoniano»— y los pair_style de LAMMPS, todos, aplican
fuerzas iguales y opuestas a los dos miembros del par. No hay forma de pedirle a un
pair_style que la aplique a uno solo. La salida es fix addforce sobre el grupo de las
ovejas, con la fuerza escrita como variables por átomo que leen la posición del perro por
su ID. Y para que el pair_style no meta nada por detrás, el par perro–oveja se declara
con una tabla idénticamente nula.
Merece la pena pararse aquí, porque es el patrón general: en LAMMPS, toda interacción
simétrica va por pair_style y toda asimetría tiene que salir del motor de pares. En
cuanto un modelo de agentes tiene jerarquía —depredador y presa, líder y seguidores,
conductor y evasores— esa asimetría aparece, y fix addforce con variables por átomo es
la herramienta. El precio es que la fuerza se evalúa con el mapa de IDs
(atom_modify map array) en vez de con la lista de vecinos: con un solo perro da igual,
con cien habría que pensarlo.
RK4 frente a velocity-Verlet. El modelo original se integra con Runge-Kutta de orden 4 y LAMMPS usa velocity-Verlet, que es de orden 2 pero simpléctico. Para un sistema disipativo como este la ventaja simpléctica no aporta nada —no hay energía que conservar—, así que lo único que importa es que el paso sea pequeño frente a las escalas del problema. El caso de validación de la sección siguiente lo confirma con doce cifras.
Detalle técnicoLas entradas de LAMMPS del ensayo, comando a comando
El sistema es 2D y las unidades son las del propio modelo, así que units lj con
dimension 2: LAMMPS no va a interpretar nada como un ángstrom. El perro es el átomo 1
(tipo 2) y las ovejas, del 2 en adelante (tipo 1), repartidas al azar en un disco:
units           lj
dimension       2
boundary        f f p
atom_style      atomic
atom_modify     map array

create_atoms    2 single ${xd0} ${yd0} 0.0 units box
region          corral sphere ${xreb} ${yreb} 0.0 ${rreb} side in units box
create_atoms    1 random ${nove} ${semi} corral units box overlap 6.0 maxtry 2000

mass            * 1.0             # masa unidad: fuerza = aceleracion
group           perro  id 1
group           ovejas subtract all perro
La cohesión entre ovejas, por tabla. g_oo no es ninguna de las formas analíticas que
trae LAMMPS, así que se tabula: LAMMPS usa el convenio contrario (F > 0 es repulsiva),
de modo que la tabla lleva F(r) = 1/r − 1/r_min y su primitiva E(r) = −ln r + r/r_min + C,
con C elegida para que la energía se anule en el radio de corte.
pair_style      table linear 20000
pair_coeff      1 1 datos/oveja-oveja.table OVEJA_OVEJA 200.0
pair_coeff      1 2 datos/nula.table NULA 1.0       # el perro no siente al rebano
pair_coeff      2 2 datos/nula.table NULA 1.0

neighbor        10.0 nsq
neigh_modify    delay 0 every 1 check yes one 10000
El radio de corte es 200, del orden del tamaño del dominio: la cohesión del modelo es de
alcance largo, y recortarla para ahorrar tiempo cambiaría el problema. Con 31
partículas, nsq (todos contra todos) es más rápido que construir cajas de vecinos.
La repulsión asimétrica del perro, con variables por átomo (variable ... atom), que
se evalúan para cada oveja leyendo la posición del perro por su ID:
variable  dx   atom x-x[1]
variable  dy   atom y-y[1]
variable  d2   atom v_dx*v_dx+v_dy*v_dy
variable  dr   atom sqrt(v_d2)
variable  gop  atom ${Fm}*exp(-v_d2/(${sigma}*${sigma}))/v_dr
variable  fox  atom v_gop*v_dx
variable  foy  atom v_gop*v_dy

fix        rep ovejas addforce v_fox v_foy 0.0
La política, con variables globales (variable ... equal) y el centro de masas del
grupo de ovejas, que es lo único que la heurística necesita saber:
compute   com ovejas com
variable  omx  equal c_com[1]
variable  omy  equal c_com[2]
variable  rdx  equal x[1]-v_omx            # u_d - u_om
variable  rdy  equal y[1]-v_omy
variable  rd   equal sqrt(v_rdx*v_rdx+v_rdy*v_rdy)
variable  hr   equal (-1.0/v_rd+1.0/${rpos})
variable  tx   equal v_omx-${xT}           # u_om - u_T
variable  ty   equal v_omy-${yT}
variable  tn   equal sqrt(v_tx*v_tx+v_ty*v_ty+1.0e-12)
variable  cosf equal (v_tx*v_rdx+v_ty*v_rdy)/(v_tn*v_rd)
variable  sat  equal v_tn/(v_tn+${dpar})   # apaga el giro sobre el objetivo
variable  hp   equal v_sat*(1.0-v_cosf)
variable  fdx  equal ${kpol}*(-v_hr*v_rdx-v_hp*v_rdy)
variable  fdy  equal ${kpol}*(-v_hr*v_rdy+v_hp*v_rdx)

fix        pol perro addforce v_fdx v_fdy 0.0
El giro de 90° es literalmente eso: (x, y)^⊥ = (−y, x), que es el cruce de signos de las
dos últimas líneas.
El resto de la dinámica son tres fijaciones y nada más. fix viscous es exactamente el
−ν v del modelo, con un coeficiente distinto para cada grupo, y enforce2d mantiene
todo en el plano:
fix        fro perro  viscous ${nup}
fix        fre ovejas viscous ${nuo}
fix        int all nve
fix        dos all enforce2d
velocity   all set 0.0 0.0 0.0
Y las medidas, que son las dos magnitudes con las que el TFM evalúa una estrategia: la distancia del centro del rebaño al objetivo y la dispersión, que es el radio de giro al cuadrado —la traza de la covarianza de las posiciones—:
variable  dist equal sqrt((v_omx-${xT})^2+(v_omy-${yT})^2)
compute   rg   ovejas gyration
variable  disp equal c_rg*c_rg
Tres cosas que no salieron a la primera
Reproducir un modelo escrito en otro lenguaje tiene siempre una parte de arqueología. Las tres que costaron, por si le ahorran a alguien el rato:
- La distancia a la que se coloca el perro no puede ser
r_min_p. La política lleva al perro ar_min_p = 10del centro del rebaño, que es el parámetro de la repulsión perro–perro. Pero un rebaño de 30 ovejas tiene un radio de unos 35: con ese valor el perro acaba dentro y lo revienta desde el medio. El propio TFM lo anticipa («es posible que esta acción disperse a las ovejas»). Aquí es un parámetro propio,r_pos = 45, calibrado para que el perro empuje desde fuera. - La cohesión no se normaliza. El TFM suma
g_oosobre todas las ovejas sin dividir porN; el código posterior sí divide porN − 1. Con la normalización, la cohesión queda treinta veces por debajo de la repulsión del perro y el rebaño se deshace en cuanto el perro se acerca: no hay pastoreo que valga. Se usa la versión del TFM, sin normalizar. El precio está dicho en «Qué no demuestra»: la cohesión escala con el número de ovejas, así que estos parámetros valen para 30. - La política es singular justo en el objetivo. Cuando el rebaño se posa sobre el
objetivo, el ángulo
φdeja de estar definido:u_om − u_T = 0y el coseno es0/0. El TFM no lo trata porque allí el rebaño nunca llega a pararse del todo. Aquí el giro se apaga de forma continua con un factord/(d + 8), que además es lo que haría un pastor: cuando el rebaño ya está, se deja de rodear. Sin eso, el perro entra en barrena y se sale del dominio.
Las tres son decisiones de implementación, no del modelo, y por eso están en el artículo en vez de escondidas en el código.
Contra qué se comprueba
Antes de mirar la animación, la parte aburrida. Una simulación bonita no demuestra nada por sí sola: hay que enseñar que lo que calcula el programa es lo que dice el papel. Aquí se comprueba en tres niveles, de más fuerte a más débil.
1. Las fuerzas son las del modelo. Se colocan dos individuos a una distancia r, se
pide a LAMMPS la fuerza sobre uno de ellos y se compara con la fórmula, en 60 distancias
entre 5 y 195.
| Interacción | Cómo se implementa | Error absoluto máx. | Error relativo máx. |
|---|---|---|---|
oveja–oveja g_oo |
pair_style table |
3,00·10⁻⁴ | 1,8·10⁻³ |
perro sobre oveja g_op |
fix addforce |
4,66·10⁻¹⁵ | 3,96·10⁻¹⁵ |
La repulsión del perro sale exacta a precisión de máquina, porque se evalúa la fórmula tal cual. La de oveja–oveja arrastra el error de interpolación de la tabla, que es el precio de poder usar una fuerza cualquiera: 0,18 %.
Y aquí hay una trampa de LAMMPS que conviene saber: pair_style table linear espacia su
tabla interna en r², no en r. Eso concentra los puntos lejos y los escasea cerca, de
modo que por debajo de r ≈ 2 la interpolación se degrada deprisa. Con la tabla empezando
en r = 0,4, el error a r = 1 era del 480 %. La tabla de este ensayo empieza en
r = 2 y las ovejas nunca se acercan tanto —la cohesión las separa mucho antes—, pero el
fallo habría sido silencioso: fuerzas mal calculadas, simulación que corre sin quejarse.
2. Un caso con solución analítica. Esta es la comprobación que de verdad vale. El
modelo de un conductor y un evasor de Escobedo, Ibáñez y Zuazua tiene, en modo persecución,
una solución asintótica exacta: los dos acaban viajando en línea recta, separados una
distancia constante y a la misma velocidad. Con los valores del artículo, esa distancia es
√2 y esa velocidad 1/√2.
| Magnitud | LAMMPS | Analítico | Error |
|---|---|---|---|
| separación perro–oveja | 1,414213562 | 1,414213562 | 2,6·10⁻¹² |
| velocidad del perro | 0,707106781 | 0,707106781 | 3,9·10⁻¹² |
| velocidad de la oveja | 0,707106781 | 0,707106781 | 1,4·10⁻¹² |
Doce cifras, con el integrador y las fuerzas de LAMMPS por medio, y sin ajustar nada:
no hay ningún parámetro libre que tocar para que salga √2. Es la diferencia entre
«parece que funciona» y «funciona»: si la asimetría estuviera mal montada, o el rozamiento
aplicado al grupo equivocado, o el paso de tiempo fuera demasiado grande, este número no
saldría.
3. El ensayo completo, que es cualitativo y no puede ser otra cosa: no hay valor de referencia para 30 ovejas. Lo que se comprueba es que el comportamiento es el que describe el TFM: llega, agrupa y oscila. Es una comprobación débil, y está presentada como tal.
Detalle técnicoEl caso de un perro y una oveja, y de dónde sale el √2
El modelo de Escobedo, Ibáñez y Zuazua (2016) es, en sus ecuaciones (3)–(4), un conductor
y un evasor con masas y rozamientos distintos. La fuerza sobre el evasor es repulsión pura;
la del conductor tiene un término de atracción–repulsión con una distancia crítica y otro
de circunvención, con una componente perpendicular gobernada por un parámetro κ: con
κ = 0 el perro persigue en línea recta, con κ = ±1 rodea. La comprobación usa κ = 0.
En LAMMPS son dos átomos y dos fix addforce, uno por agente, porque la interacción
tampoco aquí es newtoniana:
variable  rx   equal x[1]-x[2]          # u_d - u_e
variable  fex  equal -${CED}*v_rx/v_r2
variable  gar  equal -${CDE}*(1.0-${dc}*${dc}/v_r2)/v_r2
variable  gci  equal -${CR}*${d1}^4/(v_r2*v_r2)
variable  fdx  equal v_gar*v_rx+v_gci*(v_rx-${kappa}*${d2}*(-v_ry)/v_r)

fix        1 oveja addforce v_fex v_fey 0.0
fix        2 perro addforce v_fdx v_fdy 0.0
fix        3 perro viscous ${nud}
fix        4 oveja viscous ${nue}
El número cerrado sale de imponer aceleración nula en las dos ecuaciones: si los dos viajan en línea recta a velocidad constante, la fuerza de cada uno tiene que igualar a su propio rozamiento. Eso deja un sistema de dos ecuaciones,
C_DE/d (1 − d_c²/d²) + C_R d_1⁴/d³ = ν_d v , v = C_ED/(ν_e d)que con los parámetros del artículo (C_DE = 3, C_ED = 2, C_R = 0,5, d_c = d_1 = 2,
ν_d = 1, ν_e = 2) da d = √2 y v = 1/√2. El artículo publica los mismos valores.
Este ensayo se integra con su propio paso, dt = 5·10⁻⁴, mucho más fino que el del
pastoreo: las escalas de los dos problemas no son las mismas, y lo que valida es la
cadena de fuerzas, no el paso del otro ensayo.
La tercera entrada, in.fuerzas, es un bucle que recoloca un átomo con set atom 2 x ${r},
hace run 0 post no e imprime la fuerza. Es la forma más corta de sacar de LAMMPS una
curva F(r) sin integrar nada.
Qué sale
La animación es la simulación, no un vídeo: el navegador reconstruye los 300 fotogramas y los dibuja en vivo a partir de un binario de 37 KiB. La barra va a cualquier instante, y la lectura de la derecha da el tiempo y la distancia del rebaño al objetivo.
- perro (conductor)
- ovejas (evasores)
- objetivo
Lo que hay que mirar son tres momentos:
El arranque: la cohesión, no el perro. La dispersión se desploma de 1006 a 513 en las
primeras 45 unidades de tiempo, y eso no lo hace el perro: es la cohesión g_oo
recogiendo un reparto inicial al azar hacia su distancia de equilibrio. Conviene separarlo,
porque es fácil atribuirle al control un mérito que es del modelo. Lo que sí hace el perro
es cerrar distancia, de 100 a 88 — y ahí se queda, muy lejos del r_pos = 45 que le pide
la política: cada paso que da hacia el rebaño lo contrarresta el rebaño huyendo, y el
sistema se estabiliza donde las dos cosas se igualan.
El trayecto: una recta. El término de giro está prácticamente apagado desde el primer
instante (φ ≈ 6°, h_p = 0,006): la condición inicial ya deja al perro casi detrás. Así
que el perro empuja y el rebaño avanza hacia el objetivo a velocidad casi constante —la
distancia cae de forma prácticamente lineal, 0,47 unidades por unidad de tiempo— hasta
bajar de 20 en t = 400. Es el régimen bueno de la heurística: una vez detrás, no hay
nada que decidir. También es el motivo de que este ensayo diga poco sobre el término de
giro, que es la mitad interesante de la política.
| Distancia inicial del rebaño al objetivo | 202 |
| Tiempo en llegar (distancia < 20) | 400 |
| Distancia media después de llegar | 4,0 |
| Distancia máxima después de llegar | 19,5 |
| Dispersión inicial (radio de giro al cuadrado) | 1006 |
| Dispersión media después de llegar | 418 |
El final: el perro orbita. Y aquí está lo interesante. El rebaño pasa casi por encima del objetivo —la distancia baja hasta 0,79 en t = 442—, rebota hasta 5,7, y a partir de ahí el sistema se asienta en un régimen estacionario que no es el reposo:
| En el estado final | |
|---|---|
| Distancia del rebaño al objetivo | 3,34, constante |
| Distancia del perro al rebaño | 97,0, constante |
h_p = 1 − cos φ |
0,219, constante (φ ≈ 39°) |
| Periodo de la órbita del perro | ≈ 58 |
| Dispersión | 399 ± 0,2 |
El perro da vueltas alrededor del rebaño a radio constante, y el centro del rebaño describe, con el mismo periodo, una circunferencia de radio 3,34 alrededor del objetivo. No es que las magnitudes oscilen con amplitud decreciente: están exactamente fijas, y lo que rota es la dirección. Un ciclo límite de libro.
La razón está en la política, y es la que se adelantaba al presentarla: el perro empuja
siempre que está cerca, y no tiene forma de decir «ya está, me quedo quieto». Para dejar de
girar necesitaría φ = 0, es decir, estar justo detrás del rebaño visto desde el objetivo;
pero empujando desde ahí mueve el rebaño, y con el rebaño se mueve el «detrás». El sistema
se queda persiguiendo esa condición y se estabiliza con φ fijo en 39°: ni la alcanza ni
se aleja de ella.
Un detalle que no esperaba: la dispersión baja al entrar en la órbita, de 567 a 399. El perro dando vueltas aprieta el rebaño desde todos los lados. La media de 418 de la tabla anterior recoge ese tramo y el transitorio; el rebaño acaba más junto que nunca, alrededor de un objetivo que nunca acaba de alcanzar.
Eso es exactamente lo que el TFM reporta en su figura 9, y es lo que motivaba allí el paso siguiente.
Qué no demuestra esto
Cinco límites, por orden de importancia:
Una ejecución, y además benévola. Una semilla para el reparto inicial, una posición de
partida, un objetivo. Y esa posición de partida deja al perro ya casi detrás del rebaño
(φ ≈ 6°), con lo que el término de giro —la mitad no trivial de la política— apenas
interviene hasta el final. Lo honesto es decir que este ensayo valida sobre todo el
empujón. Poner al perro en el lado equivocado, o el objetivo detrás del rebaño, es la
primera variación que habría que correr, y no está hecha.
La heurística no es óptima, y aquí no se compara con nada. El ciclo límite del final no es un fallo de la implementación: es el comportamiento de esta política. Que el rebaño llegue en t = 400 no significa nada por sí solo mientras no haya con qué comparar —el control óptimo del problema de dos agentes está resuelto en la literatura, y el propio TFM tiene una política aprendida—. Este artículo reproduce la heurística y la mide; no la juzga.
Los parámetros están calibrados, no derivados. F_m = 5 frente al ≈ 7 que sugiere la
figura 5 del TFM, r_pos = 45 en vez de r_min_p, y una ganancia de 2,5 que no está en el
modelo. Son valores elegidos para que el ensayo se comporte, y por eso están marcados como
tales en la tabla de parámetros. Con otros, la misma política puede dispersar el rebaño en
vez de conducirlo.
El comportamiento depende del número de ovejas. Al no normalizar la cohesión —decisión
explicada arriba—, la fuerza que siente una oveja crece con N. Con 60 ovejas el rebaño
sería más rígido y el mismo perro empujaría relativamente menos. Estos parámetros valen
para 30, y escalar el ensayo obliga a recalibrar o a repensar la normalización.
El modelo es un modelo. Las ovejas son puntos sin visión, sin ruido, sin inercia de decisión y sin terreno; la repulsión es isótropa y la cohesión, de alcance largo. Esto no dice nada sobre ovejas de verdad, y no pretende hacerlo: es un problema de control con dinámica de partículas, y lo que se defiende es la cadena numérica —las fuerzas son las del papel, el caso con solución cerrada sale con doce cifras— y el mecanismo que produce: empujar desde detrás, agrupar, llegar y orbitar.
De la heurística al aprendizaje por refuerzo
El ciclo límite del final es justo el sitio por donde empieza el trabajo que dio origen a este modelo. La heurística «empujar y girar» tiene una virtud enorme —se escribe en dos líneas, no necesita saber dónde está cada oveja y no se entrena— y un defecto claro: lleva el rebaño al objetivo pero no lo sostiene.
El TFM planteó la alternativa: en vez de escribir la política, aprenderla. El problema se formula como un entorno de aprendizaje por refuerzo —estado: posiciones y velocidades del perro y del centro del rebaño; acción: la aceleración del perro; recompensa: estar cerca del objetivo con el rebaño junto— y se entrena una política con DDPG, un algoritmo de gradiente de política para acciones continuas. El resultado que reporta es el que cabe esperar de un controlador que optimiza una recompensa en lugar de seguir una regla geométrica: más lento que la heurística, pero estable; no deja al rebaño oscilando.
Ese trabajo está en el TFM y aquí no se reproduce. Esta simulación es el banco de pruebas: el modelo, el entorno y las métricas con las que se compara una política con otra, montados en una herramienta que corre rápido y es fácil de inspeccionar. Entrenar encima es el paso siguiente, y no está dado.
El TFM completo —modelo, heurística, formulación del entorno y resultados del entrenamiento— está en PDF. Trabajé en este problema en la Cátedra de Matemática Computacional de Deusto, donde el grupo de Enrique Zuazua lo había formulado y estudiado en el caso de dos agentes; el código original en MATLAB, del que salen los coeficientes de rozamiento que se usan aquí, está en DeustoTech/GuidanceByRepulsion.
Cómo reproducirlo
Todo está en github.com/djoroya/sim-visuales, en
particulas/pastoreo/. Un solo script:
./run.sh              # tablas, simulaciones, comprobaciones y web
./run.sh simulacion   # solo los tres ensayos de LAMMPS
./run.sh salidas      # comprobaciones, binario del visor y póster
Hace falta LAMMPS —cualquier versión reciente, sin ningún paquete opcional: todo lo que se usa está en el núcleo— y Python 3; el script crea el entorno virtual con numpy y matplotlib la primera vez. El ensayo completo son unos segundos: 31 partículas y 90 000 pasos.
Las variables de entorno útiles son NOVE (ovejas), TFIN (tiempo final), FM
(intensidad de la repulsión), RPOS (distancia a la que se coloca el perro) y NFRAMES
(fotogramas que exporta el visor). Cambiar FM y RPOS es la forma más rápida de ver por
qué están calibrados: con el perro demasiado cerca o demasiado fuerte, el rebaño se parte
en dos.
Detalle técnicoCómo cabe la simulación en esta página, y qué descarga de verdad
La trayectoria son 300 fotogramas de 31 individuos. En el disco, el volcado de LAMMPS es texto; lo que llega al navegador son 37 KiB sin comprimir, 34 con gzip, y no hace falta nada sofisticado para conseguirlo: posiciones cuantizadas a 16 bits sobre la caja común, con el byte alto y el byte bajo en planos separados para que gzip tenga algo que morder —el plano alto cambia poquísimo entre fotogramas consecutivos—. El error de reconstrucción es de 0,003 unidades de longitud, más de tres órdenes de magnitud por debajo del radio con el que se dibuja una oveja.
El visor es un canvas 2D sin dependencias. Aquí el problema es plano y son 31 círculos por fotograma: no hay nada que justifique WebGL, ni three.js, ni un paquete. Son 9 KiB de fuente —2,3 una vez empaquetados y comprimidos— y dibujan el objetivo, la estela del perro y los individuos interpolando entre fotogramas para que la animación no vaya a saltos.
Lo que descarga de verdad quien lee esta página, medido sobre la compilación de la web y comprimido como lo sirve el servidor:
| Transferido | |
|---|---|
| El artículo entero (HTML + CSS) | 18 KiB |
| Póster PNG, en el HTML y compartido por los dos visores | 5,8 KiB |
| El cargador diferido, dentro del módulo de la página | 1,4 KiB |
| El visor, nada más abrir (la animación está arriba) | 2,3 KiB |
Trayectoria .herd, una sola vez para los dos visores |
34 KiB |
Tiempos, distancia y dispersión (meta.json) |
1,7 KiB |
| Total con la animación en marcha | ≈ 63 KiB |
Un artículo con una simulación dentro que pesa menos que una sola fotografía.
El cargador es un IntersectionObserver de menos de 1 KB que no pide nada hasta que su
figura está a 300 px de entrar en pantalla. Y si has pedido menos movimiento en tu
sistema, los dos visores se comportan distinto a propósito: la animación de la cabecera no
llega a montarse —el póster ya es el fotograma fijo que estás pidiendo—, mientras que este
de aquí sí, porque aquí la simulación es el contenido del artículo; se monta parado, en un
instante representativo, con la barra de tiempo para recorrerlo a mano.
Referencias. J. Oroya, Aprendizaje por refuerzo aplicado al problema del pastoreo, TFM, Máster en Ingeniería Computacional y Sistemas Inteligentes, UPV/EHU, 2020; director: Roberto Santana — modelo y política que se implementan aquí. · R. Escobedo, A. Ibáñez, E. Zuazua, Optimal strategies for driving a mobile agent in a “guidance by repulsion” model, Commun. Nonlinear Sci. Numer. Simul. 39 (2016) 58–72 (arXiv:1509.05008). · D. Ko, E. Zuazua, Asymptotic behavior and control of a “guidance by repulsion” model (arXiv:1911.01133) y Model predictive control with random batch methods for a guiding problem (arXiv:2004.14834).