Un rebaño que no es un disco
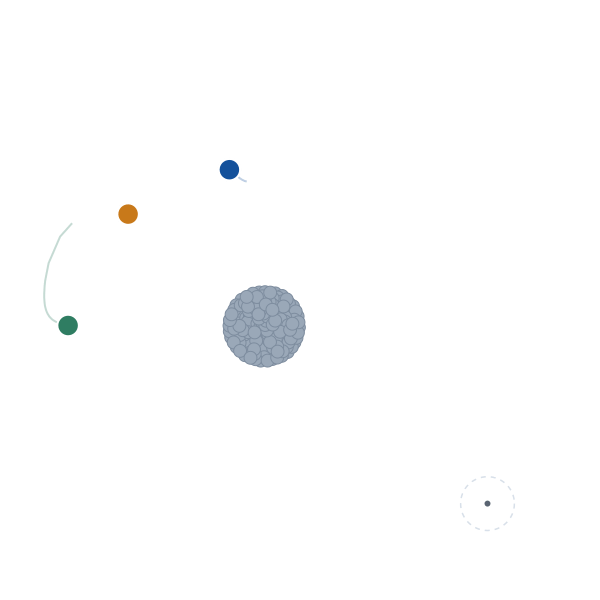
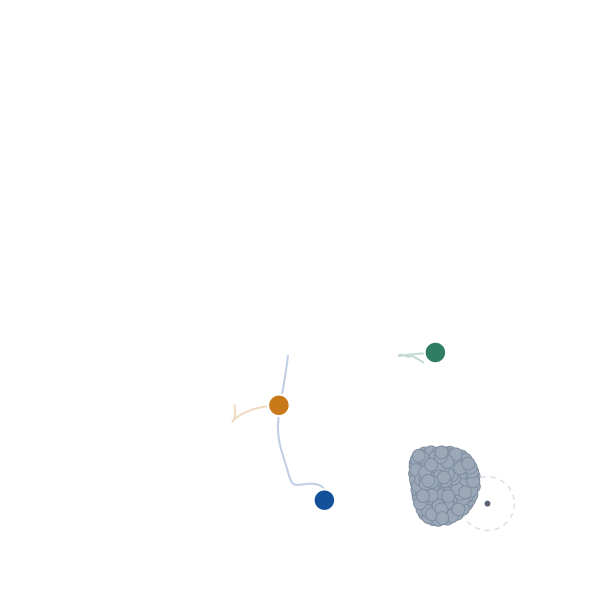
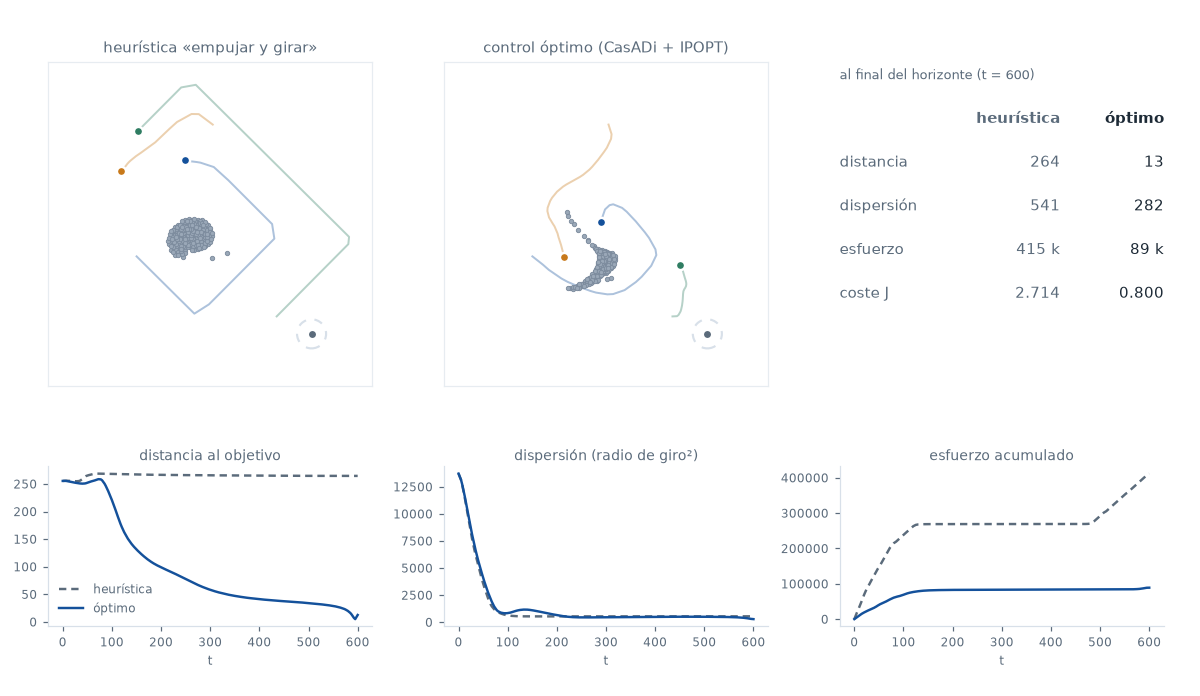
El artículo anterior terminaba con una pregunta: todo aquello empezaba con el rebaño en disco, que es el caso fácil. Aquí las mismas 200 ovejas empiezan repartidas en una banda curva con dos grumos, la cohesión entre ellas baja a un quinto —el grupo se deja abrir y estirar— y los tres perros arrancan donde más estorban. La heurística no mueve este rebaño: lo deja a 264 del objetivo, donde empezó. El control óptimo sí, y por el camino deja dos lecciones de calibración que valen más que el resultado.
Lectura rápida
- De dónde viene. Es la segunda parte de De la heurística al control óptimo: 3 perros, 200 ovejas. Mismo modelo, mismo código, mismo coste; lo único que cambia es el estado inicial y dos parámetros.
- Qué cambia. El rebaño ya no tiene forma de nada: radio de giro 117 frente a los 23,5 del rebaño en reposo. Y con la cohesión a un quinto () se deja deformar, en vez de comportarse como un sólido.
- Por qué la heurística se queda clavada. Coloca a los perros a una distancia fija del centro del rebaño, y con un rebaño así esa distancia sale 165. A 165 unidades la repulsión del perro vale : uno entre cincuenta mil de . Los perros están ahí, pero es como si no estuvieran.
- Qué sale. Distancia final 264,5 frente a 12,5; esfuerzo 414 692 frente a 88 918; coste 2,714 frente a 0,800.
- Lo que no hacen los perros. Reunir los dos grumos. Eso lo hace la cohesión sola, y se ve porque en el panel de la heurística pasa exactamente igual.
- Lo que sí hace el óptimo. Vuelve a estirar el rebaño en forma de riñón para arrastrarlo —la dispersión sube de 838 a 1 127 entre y — y lo cierra al final, de 500 a 282.
- Las dos lecciones de calibración. La dispersión hay que medirla contra el rebaño en reposo, no contra la inicial; y un ensayo con menos ovejas no es representativo, porque la cohesión que siente una oveja crece con el tamaño del rebaño.
- Lo que cuesta. 1 440 incógnitas, 300 iteraciones, 3 h 30 min de IPOPT para
acabar en
Maximum_Iterations_Exceededcon la infactibilidad dual en 11. Aquí ni siquiera se puede decir que esté cerca de un punto estacionario.
Qué cambia respecto a la primera parte
Nada del planteamiento. El modelo es el mismo —puntos de masa unidad, cohesión oveja-oveja, repulsión asimétrica del perro—, el coste es el mismo funcional de cuatro términos, la discretización es la misma (disparo simple, RK4 con , control constante a trozos) y el optimizador es el mismo IPOPT con hessiano L-BFGS. Lo que cambia es dónde empieza todo y dos parámetros.
El rebaño no tiene forma de nada. Las 200 ovejas se reparten a lo largo de un arco que cubre 300 unidades de ancho y se eleva 260, con dos masas densas —el 38 % y el 34 % de las ovejas— unidas por un reguero ralo con el resto. El radio de giro de partida es 117; el de este mismo rebaño dejado en reposo, 23,5. En términos de dispersión —radio de giro al cuadrado, que es lo que mide el coste—, 13 713 frente a 550: veinticinco veces.
El rebaño se deja deformar. La cohesión oveja-oveja se escala por . Con el modelo del TFM, a 200 individuos, mantiene el grupo unido pase lo que pase: en la primera parte el rebaño nunca se desparramaba, y ahí ya quedó dicho que eso era suerte, no diseño. Bajándola a un quinto, la repulsión del perro es comparable a lo que mantiene unido al grupo, y el rebaño se abre, se estira y se deja moldear. Que es lo que hace interesante el problema.
Los perros empiezan estorbando. El azul, dentro del grumo grande; el naranja, al otro lado de la banda; el verde, entre el rebaño y el objetivo. Ninguno de los tres está donde la intuición los pondría.
Y, por lo demás: horizonte en 240 intervalos de control, 1 440 incógnitas, cota por componente. Pesos , , , .
Detalle técnicoLos pesos, uno a uno, y por qué estos
pesa la dispersión al final; , la dispersión promediada a lo largo del horizonte; , la distancia del centro al objetivo en cada instante; , el esfuerzo. Los cuatro términos están normalizados para que valgan cuando no se ha hecho nada y cuando está perfecto, así que los pesos se leen como fracciones de «llegar».
Respecto a la primera parte, sube de 0,2 a 0,3, de 0,5 a 0,8 y entra en escena con 0,18. Lo de es el mismo argumento de allí, agravado: el gradiente del coste terminal respecto a los primeros controles atraviesa ahora 240 intervalos de dinámica disipativa en vez de 160, y llega todavía más aplastado. Lo de es la lección de la primera parte aplicada antes de que duela: con un rebaño que se deja deformar, pedir compacidad solo al final autoriza al optimizador a estirarlo todo el camino.
Dicho esto, y para no vender como medido lo que no lo está: estos tres valores no salen de un barrido. Cada corrida son tres horas y media, así que lo que hay es la tanda que se eligió y una variante, la de la sección del seguro. El barrido de pesos sigue siendo la parte cara de este tipo de problemas.
Es útil ver el coste final desglosado, porque dice en qué se está gastando el 0,800:
| contribución a | heurística | óptimo |
|---|---|---|
| llegar | 1,073 | 0,002 |
| dispersión final | 0,295 | 0,154 |
| dispersión del camino | 0,411 | 0,436 |
| seguimiento | 0,862 | 0,192 |
| esfuerzo | 0,073 | 0,016 |
| total | 2,714 | 0,800 |
De los 0,800 que le quedan al óptimo, 0,436 son dispersión del camino, y eso es irreducible: el rebaño empieza a 25 veces la dispersión de reposo y la cohesión tarda unas 100 unidades de tiempo en recogerlo. Ni el mejor control del mundo baja ese término mucho más. Lo que el optimizador sí ha llevado prácticamente a cero es «llegar»: 0,002.
Por qué la heurística no puede
No es que lo haga mal. Es que no toca al rebaño.
La política del TFM coloca al perro a una distancia fija del centro del rebaño y lo hace girar hasta ponerse detrás. Ese no puede ser cualquiera: si se queda corto, el perro aparece dentro del grupo y lo revienta desde el medio. En la primera parte se tomaba el radio del rebaño inicial más 25. Aquí el radio lo fijaría una oveja suelta del extremo de la banda, así que se usa el percentil 80 de los radios —140— más 25: .
Y ahí está el problema entero. La repulsión del perro sobre la oveja es con y . A 165 unidades eso vale
uno entre cincuenta mil de . Los tres perros se colocan en su consigna, orbitan educadamente y no empujan nada. La tira de instantes lo cuenta sin más comentario:
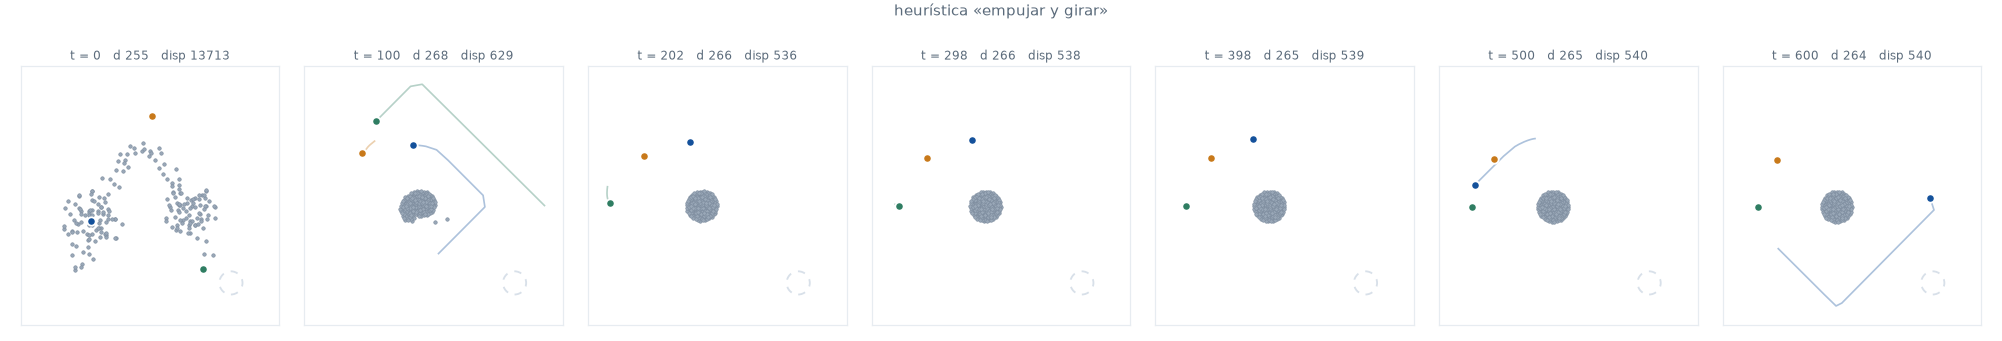
En números: la distancia al objetivo empieza en 255,4, sube a 268 hacia —los perros alcanzan todavía a las ovejas del extremo de la banda, y lo que consiguen es empujar el rebaño al revés— y acaba en 264,5. Seiscientas unidades de tiempo para alejarse nueve.
El esfuerzo, mientras tanto, es de 414 692, más que el del óptimo por un factor cinco. No se gasta en empujar: 238 272 se van en los primeros 100 en llegar a la consigna, y el resto en un barrido final cuando el rebaño, ya compacto, se queda a un lado y el término de giro vuelve a activarse.
Esto es coherente con lo que pasaba con 200 ovejas en disco —allí la heurística recorría 115 de las 202 unidades que le pedían—, solo que llevado al extremo. Y es exactamente la limitación que el propio TFM le atribuye: «tiene limitaciones cuando la dispersión de las ovejas es grande con respecto a la distancia entre la media de las posiciones de las ovejas y la posición del perro».
Qué hace el óptimo
Tres fases, y conviene mirarlas con la tira delante.
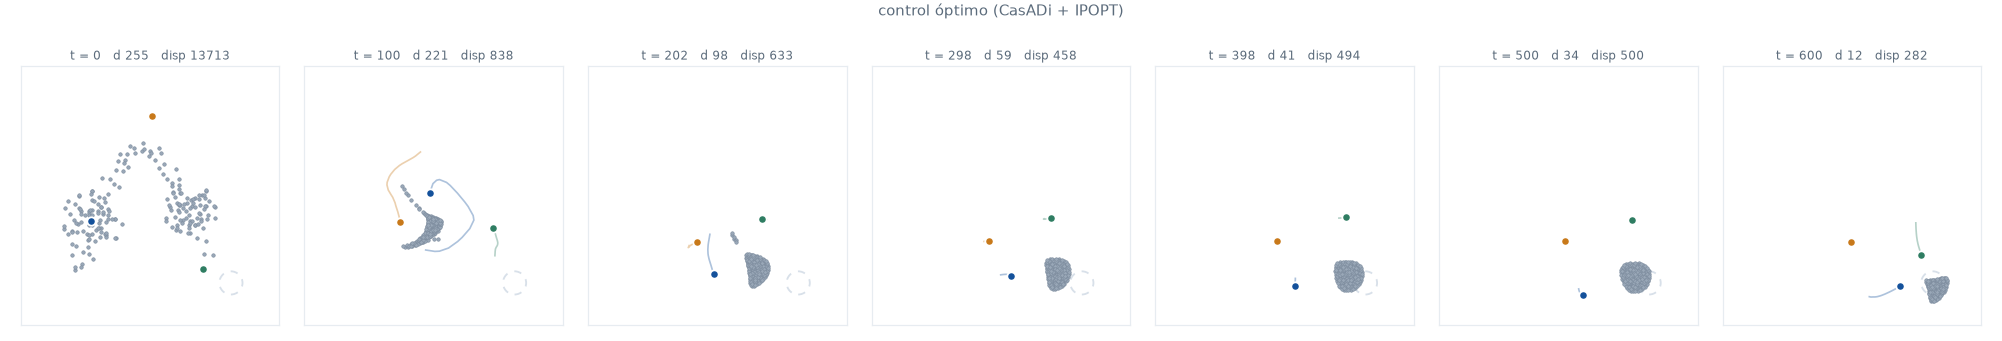
Lo primero es lo que no hacen los perros. Entre y los dos grumos se juntan y la dispersión cae de 13 713 a 838. Es tentador apuntarlo en la cuenta del control óptimo, y sería falso: en el panel de la heurística, en el mismo tramo, la dispersión cae de 13 713 a 629, más todavía. Lo que reúne el rebaño es su propia cohesión. El óptimo, de hecho, lo reúne menos, porque ya está tirando de él mientras se junta.
Lo que sí hacen los perros en ese tramo es gastar: el 50 % del esfuerzo total del óptimo se consume antes de , y el 90 % antes de . Todo lo demás —463 unidades de tiempo— sale casi gratis.
Después lo estira a propósito. Entre y la dispersión del óptimo vuelve a subir, de 838 a 1 127, mientras la de la heurística se queda plana en 535. Esa subida es el riñón de la segunda viñeta: el rebaño alargado en la dirección de la marcha, con el perro azul describiendo un lazo por detrás y el naranja cerrando por arriba. Y es justo el tramo en el que más avanza: la distancia pasa de 221 a 131.
Tiene sentido. Empujar un grupo compacto cuesta vencer su inercia entera de golpe; estirarlo deja que las ovejas de cabeza arrastren a las de cola por cohesión, y el perro solo tiene que mantener la presión por detrás. Que el optimizador encuentre eso sin que nadie se lo cuente es el motivo de escribir el problema como un control óptimo en vez de como una regla.
Y al final lo cierra. De a los perros están prácticamente parados y el rebaño se desliza: 100 → 34 de distancia, con el esfuerzo plano. En las últimas 100 unidades dos de los tres perros se cierran sobre el grupo y la dispersión baja de 500 a 282, la mitad de la que deja la heurística.
| Al final del horizonte () | heurística | óptimo |
|---|---|---|
| coste | 2,714 | 0,800 |
| distancia al objetivo | 264,5 | 12,5 |
| distancia mínima | 254,8 | 5,0 |
| cuándo baja de 20 | nunca | t = 580 |
| dispersión final (radio de giro²) | 541 | 282 |
| esfuerzo | 414 692 | 88 918 |
Conviene leer esa tabla sin entusiasmo. El óptimo llega, y gastando una quinta parte, pero llega tarde: no baja de 20 hasta , con el horizonte acabándose. La distancia va 221 en , 100 en , 59 en , 41 en y 34 en . Es un arrastre largo y lento, no una conducción limpia.
- los tres perros
- 200 ovejas
- objetivo
Lo que hubo que calibrar
Las dos cosas que costaron, y que no son evidentes hasta que muerden.
La dispersión hay que medirla contra el rebaño en reposo
El término «no dispersar» del coste es un cociente: dispersión final dividida por una referencia. En la primera parte la referencia natural era la dispersión inicial, y funcionaba, porque el rebaño empezaba compacto y acabar como empezó era una exigencia razonable.
Aquí eso se rompe. La dispersión inicial es 13 713, así que el término vale 1 al empezar y cualquier cosa parece buenísima: dejar el rebaño estirado en una banda de dispersión 3 000 ya puntúa 0,22. El término no muerde, el optimizador se da cuenta y entrega exactamente lo que se le ha pedido —un rebaño desparramado que casualmente tiene el centro de masas donde toca—.
El arreglo es cambiar la referencia por la dispersión del rebaño en reposo:
--disp-ref 550, que es dónde se estabiliza este mismo rebaño si se le deja sin nadie
que lo moleste. Con eso, «agrupar = 1» significa «tan junto como el rebaño sabe estar»,
que es una exigencia con sentido físico y no un accidente del estado inicial.
Es la misma moraleja de la primera parte vista desde otro ángulo: allí el problema estaba en cuándo se medía la dispersión, aquí en contra qué. El optimizador no hace lo que uno quiere, hace lo que uno escribe.
Una prueba con menos ovejas no es una prueba pequeña
Esta costó más, porque da un resultado falso que parece verdadero.
La cohesión total que siente una oveja escala con el número de ovejas: se suma sobre todo el rebaño, sin normalizar. Un ensayo de tanteo con 80 ovejas y el mismo no es «el mismo problema más pequeño»: es un rebaño 2,5 veces más suelto. La primera tanda de pruebas se hizo así, para que cada corrida tardase minutos en vez de horas, y daba a entender que con el rebaño quedaba desparramado y había que subir la cohesión. Con 200 ovejas no era verdad.
Para que un ensayo reducido sea representativo hay que escalar por . Y la regla general, que vale para cualquier modelo de partículas con interacciones sumadas y no promediadas: antes de usar una versión pequeña como banco de pruebas, comprobar qué parámetros efectivos cambian con . Aquí era uno y bastó para mandar media tarde en la dirección equivocada.
Detalle técnicoLa variante de seguro, que sale mejor en los números
Se corrieron dos versiones. La que se enseña arriba —, — y una de seguro, con la cohesión algo más alta y más peso a la compacidad del camino.
| distancia final | dispersión final | baja de 20 | esfuerzo | |||
|---|---|---|---|---|---|---|
| heurística | 0,20 | — | 264,5 | 541 | nunca | 414 692 |
| la de arriba | 0,20 | 0,18 | 12,5 | 282 | t = 580 | 88 918 |
| la de seguro | 0,25 | 0,25 | 5,4 | 199 | t = 295 | 105 525 |
La de seguro gana en casi todo: llega el doble de cerca, acaba más compacta y baja de 20 en en vez de agotando el horizonte. Lo paga con un 19 % más de esfuerzo… y con la forma. Con la cohesión más alta el rebaño se apelotona antes y deja de parecerse al problema del enunciado: en su dispersión ya es 430, frente a los 838 de la otra. El riñón no llega a formarse.
O sea que la corrida que se enseña en el artículo no es la mejor por los números; es la que conserva más tiempo el rebaño deformable que daba sentido al escenario. Queda dicho, porque elegir la figura bonita y presentarla como la óptima es precisamente lo que un artículo así no debería hacer.
Lo que cuesta calcularlo
| incógnitas (, con ) | 1 440 |
| estado | 812 números |
| construir el grafo | 0,6 s |
| simular la heurística | 3,2 s |
| IPOPT, 300 iteraciones | 3 h 30 min |
| estado al parar | Maximum_Iterations_Exceeded |
| infactibilidad dual al parar | 11 |
Tres horas y media para una trayectoria, en lazo abierto, válida para un solo estado inicial. Es justo el doble que la primera parte (105 min), y el reparto es el esperable: 50 % más de intervalos por 50 % más de iteraciones.
Lo que no es un detalle es la última fila. En la primera parte IPOPT paraba por iteraciones con la infactibilidad dual en : lejos de la tolerancia pedida, pero razonablemente cerca de un punto estacionario. Aquí para en 11, sobre un objetivo que vale 0,800. Eso no es «casi convergido con otro nombre»: es que el problema con el rebaño blando es mucho más duro —más no convexo, con la cohesión débil permitiendo configuraciones del rebaño muy distintas a poca distancia en el espacio de controles— y 300 iteraciones de L-BFGS no bastan ni de lejos.
De modo que lo único que este artículo afirma es: ese punto es muchísimo mejor que la heurística. Nada sobre optimalidad.
Qué no demuestra esto
No está convergido, y aquí importa más que antes. Lo de arriba. Con la infactibilidad dual en 11, ni siquiera vale el consuelo de «está en un mínimo local». Es el mejor punto que IPOPT alcanzó en tres horas y media partiendo de la heurística. Y como la heurística aquí no hace nada, el arranque en caliente es prácticamente un arranque frío: el optimizador salió del cero por el término de seguimiento, igual que en el caso grande de la primera parte.
«Llegar» se sigue midiendo con el centro de masas. La primera parte terminaba diciendo que lo difícil de un rebaño irregular era decidir qué significa llegar cuando el rebaño no es un punto. Esa pregunta aquí no está resuelta: el coste sigue usando , el centro de masas, que en una banda con dos grumos cae en el reguero ralo del medio, donde casi no hay ovejas. Funciona porque la cohesión convierte el rebaño en algo compacto en las primeras 100 unidades de tiempo, y a partir de ahí el centro vuelve a representar al grupo. Lo que se ha arreglado es la referencia de la dispersión, no la definición de llegada. Un funcional que midiera, por ejemplo, la fracción de ovejas dentro de un radio del objetivo sería la respuesta honesta, y no está escrito.
Sigue siendo lazo abierto, y una sola condición inicial. Si una oveja se desvía, nadie corrige. Si se mueve el estado inicial, vuelta a pagar las tres horas y media. La versión seria es MPC —reoptimizar sobre un horizonte corto cada pocos pasos—, que es lo que hacen Ko y Zuazua con random batch, o una política aprendida, que es adonde se fue el TFM.
No hay barreras ni cercas. El enunciado natural siguiente —penalizar que el rebaño se salga de una zona, o meter un obstáculo— no está. Y es el que de verdad distinguiría una política de otra.
Y el modelo sigue siendo un modelo. Ovejas que son puntos sin visión, sin ruido y sin terreno; cohesión de alcance largo y sin normalizar. Lo que se defiende es la cadena numérica, que es la misma que ya se validó en la primera parte: la dinámica contrastada contra LAMMPS con un 0,05 % de desvío y el gradiente contra diferencias finitas con .
Cómo reproducirlo
Todo está en github.com/djoroya/sim-visuales,
en control/pastoreo-optimo/:
./run.sh espectacular   # el escenario irregular: ~3,5 h
./run.sh escalera       # las comprobaciones de la primera parte (~5 min)
./run.sh salidas        # binario del visor, póster e informe
Hace falta Python 3 con CasADi, numpy y matplotlib; el script crea el entorno virtual la
primera vez. Lo barato e instructivo es tocar --k-oo, --lam-t y --disp-ref con
pocas ovejas —acordándose de escalar por , que para eso está la
lección de arriba—.
Detalle técnicoCómo caben las dos simulaciones en esta página
Lo mismo que en la primera parte, y por el mismo precio: cada escena son 150 fotogramas de 203 individuos, hay dos, y lo que llega al navegador son 238 KiB sin comprimir. Las posiciones van cuantizadas a 16 bits sobre la caja común, con el byte alto y el bajo en planos separados para que gzip tenga algo que morder; el error de reconstrucción es de 0,004 unidades de longitud, tres órdenes de magnitud por debajo del radio con el que se dibuja una oveja.
La caja aquí es más grande que la de la primera parte —558 unidades de lado frente a 422, porque la banda inicial ocupa mucho más— y eso es todo lo que cambia en el visor: el mismo canvas 2D sin dependencias, los mismos 203 círculos por panel y la misma carga diferida hasta que la figura está a 300 px de entrar en pantalla. Los dos pósters PNG (7 KiB cada uno) los genera el mismo script a partir del propio binario, en el instante exacto en el que el visor se queda parado si has pedido menos movimiento.
Referencias. J. Oroya, Aprendizaje por refuerzo aplicado al problema del pastoreo, TFM, Máster en Ingeniería Computacional y Sistemas Inteligentes, UPV/EHU, 2020; director: Roberto Santana — modelo, parámetros y heurística; está en la página de artículos con su PDF. · R. Escobedo, A. Ibáñez, E. Zuazua, Optimal strategies for driving a mobile agent in a “guidance by repulsion” model, Commun. Nonlinear Sci. Numer. Simul. 39 (2016) 58–72 (arXiv:1509.05008). · D. Ko, E. Zuazua, Model predictive control with random batch methods for a guiding problem (arXiv:2004.14834) — el lazo cerrado que aquí sigue sin estar. · J. Andersson et al., CasADi: a software framework for nonlinear optimization and optimal control, Math. Prog. Comp. 11 (2019) 1–36. · Código original en MATLAB, de la Cátedra de Matemática Computacional de Deusto: DeustoTech/GuidanceByRepulsion.