De la heurística al control óptimo: 3 perros, 200 ovejas
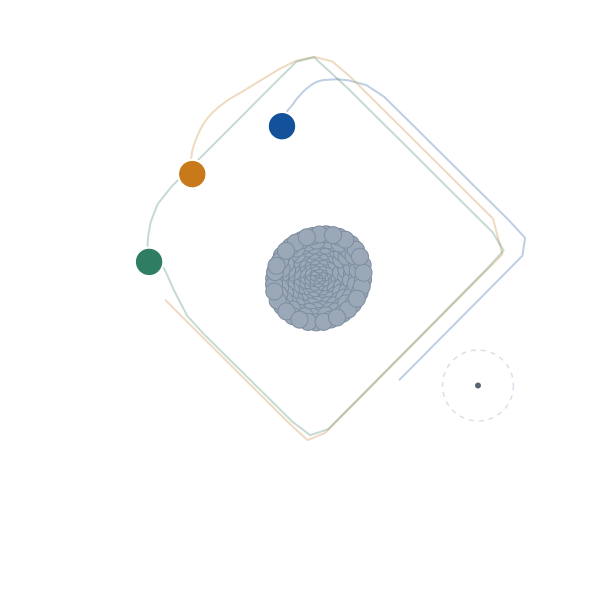
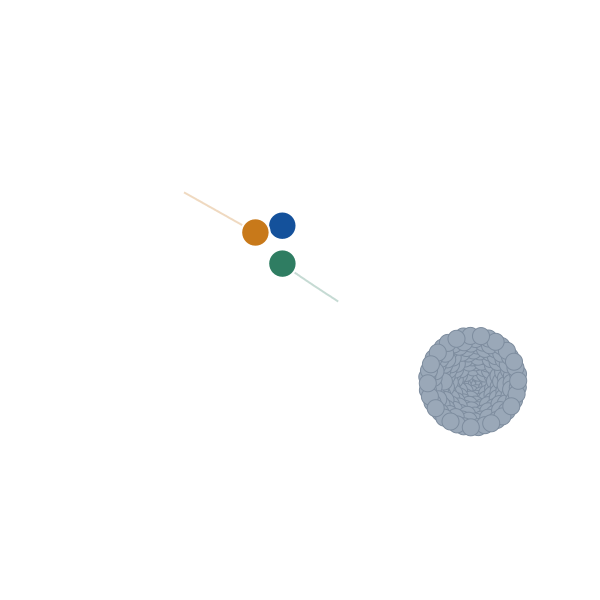
La heurística del artículo anterior —colocarse detrás del rebaño y empujar— llevaba 30 ovejas al objetivo. Con 200 ya no llega. Esto es el mismo problema escrito como un problema de control óptimo: en vez de decidir qué hace el perro en cada instante, se escribe lo que se quiere conseguir y lo encuentra un optimizador. Con CasADi, IPOPT y dos horas de CPU.
Lectura rápida
- De dónde viene. Es la continuación de Guiar un rebaño con un perro que solo repele, donde la política «empujar y girar» del TFM se montó en LAMMPS y acababa en un ciclo límite: llegaba, pero no se paraba. Aquí cambia la escala —200 ovejas y 3 perros— y cambia el enfoque.
- Por qué hace falta. Con 200 ovejas la heurística se queda a 86,9 del objetivo al acabar el horizonte, después de gastar 428 300 de esfuerzo dando vueltas. No es un fallo de la implementación: es la limitación que el propio TFM le atribuye.
- El planteamiento. Estado de 812 números, control las aceleraciones de los tres perros acotadas a por componente, y un coste con cuatro términos normalizados —llegar, no dispersar, esfuerzo y seguimiento— de modo que signifique literalmente «agrupar pesa una quinta parte de llegar».
- Cómo se resuelve. Disparo simple: las incógnitas son solo los 960 controles y el estado sale de integrar con RK4. El gradiente, por diferenciación automática inversa de CasADi; la minimización, IPOPT con hessiano L-BFGS.
- Qué sale. Distancia final 2,0 frente a 86,9; llega a menos de 20 en t = 60, la heurística nunca; esfuerzo 39 982 frente a 428 300. El óptimo no gana por poco: llega, y gastando diez veces menos.
- Lo que no es gratis. 105 minutos de IPOPT para no converger: para en el máximo de iteraciones con la condición KKT en 3,6·10⁻⁴. Es el mejor punto encontrado, no un óptimo certificado.
- La lección transferible. El optimizador no hace lo que uno quiere, hace lo que uno escribe: pedir compacidad solo al final le autoriza a estirar el rebaño en un arco a mitad de camino, y con 20 ovejas lo hace.
- Se puede repetir. Un
run.sh, Python con CasADi y una escalera de comprobaciones que se ejecuta en cinco minutos.
Por qué la heurística deja de funcionar
La política del artículo anterior cabe en dos frases: un término radial coloca al perro a una distancia fija del centro del rebaño y un término tangencial lo hace girar hasta ponerse detrás, en la línea que une rebaño y objetivo. Con 30 ovejas funciona: el perro empuja, el rebaño avanza en diagonal y llega.
Con 200 ovejas el rebaño ocupa mucho más sitio. Los perros tienen que colocarse más lejos —aquí, al radio del rebaño inicial más 25—, y desde más lejos cada corrección de ángulo es una vuelta más larga. El resultado está en el panel izquierdo de la animación: los tres perros se pasan el horizonte orbitando alrededor del rebaño, que avanza a regañadientes.
| En 400 unidades de tiempo, con la heurística | |
|---|---|
| Distancia inicial del rebaño al objetivo | 202,4 |
| Distancia al final del horizonte | 86,9 |
| Cuándo baja de 20 | nunca |
| Esfuerzo | 428 300 |
Conviene decir lo que esto no es: no es que la política se rompa ni que el rebaño se disperse —la dispersión se queda en 524, por debajo de la de partida—. Es que no da tiempo. Donde con 30 ovejas recorría 202 unidades en 400 de tiempo, con 200 recorre 115.
Y es exactamente lo que el TFM anticipaba de su propia heurística: que «tiene limitaciones cuando la dispersión de las ovejas es grande con respecto a la distancia entre la media de las posiciones de las ovejas y la posición del perro». Cuando el rebaño es grande y el perro está lejos, girar sale caro.
Detalle técnicoTres perros con una política escrita para uno
La heurística del TFM es para un solo perro, y los tres tendrían la misma consigna: se amontonarían detrás del rebaño, en la misma línea, empujando los tres en el mismo sitio. Se reparte el arco dando a cada perro un desfase respecto a la línea rebaño → objetivo, con rad. El resto es la fórmula del TFM, incluido el apagado continuo del giro cerca del objetivo —el factor — que ya hacía falta en la versión de LAMMPS.
Dos detalles más de la comparación, por si parecen trampas y no lo son:
La heurística se simula en lazo cerrado, no congelada. Es una ley de realimentación en tiempo continuo: congelarla durante un intervalo de control entero —2,5 unidades, doce veces la escala de tiempo del perro— la vuelve inestable y la dejaría peor de lo que es. Se evalúa en cada subpaso de RK4. Lo que se compara con el control óptimo es su acción media por intervalo; el esfuerzo, en cambio, se acumula subpaso a subpaso, porque promediar antes de elevar al cuadrado le rebajaría la factura.
Las dos políticas juegan con las mismas cartas. El óptimo está acotado a por componente. La heurística sin cota llega a pedir aceleraciones de 430 —su término de giro crece con la distancia al rebaño—, pero en una corrida de 30 ovejas y un perro su mediana es 5,5 y su percentil 90, 52. Con la heurística hace prácticamente lo mismo que sin cota (con un perro y 30 ovejas llega en t = 495 en vez de t = 435), así que el óptimo no gana por tener más autoridad.
El problema de control óptimo
El modelo es el mismo del artículo anterior y no se ha tocado ni un parámetro: puntos de masa unidad en el plano, fuerzas radiales y rozamiento, con la repulsión del perro sobre la oveja asimétrica —la oveja huye, el perro no siente la reacción—. Con ovejas y perros:
con , y . Las son el control. El estado son las posiciones y velocidades de todos: con 200 ovejas y 3 perros, números.
El coste
Cuatro términos, todos normalizados para que los pesos signifiquen algo:
sujeto a , donde es el centro del rebaño, su distancia inicial al objetivo y el número de intervalos de control. Cada término vale para «no he hecho nada» y para «perfecto», así que quiere decir literalmente que agrupar pesa una quinta parte de llegar. Pesos usados: , , .
Los dos primeros términos y el esfuerzo son los del TFM. El seguimiento no estaba en el enunciado, y conviene justificarlo con números en vez de con intuición: el gradiente del coste terminal respecto a los primeros controles atraviesa 160 intervalos de dinámica disipativa y llega aplastado. Lo que compra es que los perros empujen desde el principio en vez de dejarlo todo para el final. Pero no es imprescindible: con el optimizador también lleva las 200 ovejas al objetivo, solo que gastando el triple (esfuerzo 120 377 frente a 39 982) y quedándose algo más lejos (3,1 frente a 2,0).
Una regularización que no es cosmética
Un optimizador basado en gradiente necesita que todo sea derivable, y en el modelo tal cual hay dos sitios donde no lo es: revienta en y la norma no es derivable en el origen. Las dos se arreglan de una vez evaluando las fuerzas en
tanto en el como en el vector unitario . La fuerza resultante es analítica en todas partes y tiende a cero linealmente cuando dos individuos se superponen, en vez de diverger. El precio es un error relativo de : con la distancia típica entre ovejas, unas 10 unidades, un 0,5 %. Lo que eso supone en una trayectoria entera está medido contra LAMMPS más abajo, y son 5 diezmilésimas del recorrido.
Cómo se resuelve, y cuánto cuesta
Disparo simple. Las incógnitas son solo los controles; el estado sale de integrar. No hay restricciones de dinámica —se cumplen por construcción— y el problema queda como una minimización con cotas de caja, que es lo que mejor le sienta a IPOPT con hessiano L-BFGS.
| horizonte | |
| intervalos de control | 160 (), control constante a trozos |
| integración | RK4, 10 subpasos por intervalo () |
| incógnitas | |
| gradiente | adjunto (AD inversa) de CasADi |
| optimizador | IPOPT, hessian_approximation = limited-memory |
La dinámica está vectorizada: las 200 × 200 distancias entre ovejas son dos repmat
y un mtimes, no un bucle de Python. Y el bucle temporal se cierra con mapaccum, que
repite el cuerpo del intervalo sin desplegar el grafo 160 veces: construirlo entero
cuesta medio segundo y toda la sesión —coste, gradiente e IPOPT— cabe en 200 MB.
| Lo que cuesta | |
|---|---|
| construir el grafo (812 estados, 160 intervalos) | 0,5 s |
| una evaluación del coste | 2,5 s |
| un gradiente completo por AD inversa | 23 s |
| 200 iteraciones de IPOPT (1093 costes + 201 gradientes) | 105 min |
| memoria | 200 MB |
| infactibilidad dual al parar | 3,6·10⁻⁴ |
Ese gradiente de 23 segundos es la razón de ser de la diferenciación automática inversa. Por diferencias finitas harían falta 961 evaluaciones del coste —más de 40 minutos— para el mismo vector, y encima aproximado. El coste de la AD inversa, en cambio, no depende del número de incógnitas: es un múltiplo pequeño del coste de evaluar una vez.
Detalle técnicoEl código: la dinámica vectorizada, el bucle con mapaccum y la llamada a IPOPT
Las fuerzas, sin un solo bucle sobre individuos. A es 2 × n, B es 2 × m, y g
devuelve el módulo con signo de la fuerza (negativo = repulsión). Lo que sale es la suma
de las fuerzas que los de B hacen sobre los de A, en 2 × n:
def _radial(A, B, g, eps, quita_diagonal=False):
    n, m = A.shape[1], B.shape[1]
    dx = ca.repmat(B[0, :], n, 1) - ca.repmat(A[0, :].T, 1, m)   # [i,k] = b_k - a_i
    dy = ca.repmat(B[1, :], n, 1) - ca.repmat(A[1, :].T, 1, m)
    r = ca.sqrt(dx * dx + dy * dy + eps * eps)     # la regularizacion, aqui
    c = g(r) / r                                   # g(r) * d/r = (g(r)/r) * d
    if quita_diagonal:
        c = c * (ca.DM.ones(n, m) - ca.DM.eye(n))
    uno = ca.DM.ones(m, 1)
    return ca.horzcat(ca.mtimes(c * dx, uno), ca.mtimes(c * dy, uno)).T
La suma sobre vecinos es un producto por un vector de unos: para CasADi es una
operación matricial de 40 000 elementos, no 40 000 nodos en el grafo. Con la misma
función salen las tres interacciones, y la asimetría del modelo es simplemente que
F_op no aparece en la ecuación de los perros:
F_oo = _radial(X, X, g_oo, p.eps, quita_diagonal=True)
F_op = _radial(X, Y, g_op, p.eps)
F_pp = _radial(Y, Y, g_pp, p.eps, quita_diagonal=True)

dV = -p.nu_o * V + F_oo + F_op          # ovejas: cohesion + repulsion del perro
dW = -p.nu_p * W + F_pp + a             # perros: no sienten al rebano
El integrador y el bucle. Un intervalo de control son m subpasos de RK4 con la
acción congelada, desenrollados dentro del cuerpo porque son pocos. El bucle sobre los
160 intervalos va fuera, con mapaccum, que no desenrolla:
def func_intervalo(p, h, m):
    z = ca.MX.sym("z", p.n_est)
    a = ca.MX.sym("a", 2 * p.n_p)
    zk = z
    for _ in range(m):
        zk = paso_rk4(zk, a, h, p)
    return ca.Function("intervalo", [z, a], [zk], ["z", "a"], ["zn"])

def trayectoria(paso, z0, A):            # A es 2*n_p x N
    return paso.mapaccum("rollout", A.shape[1])(z=z0, a=A)["zn"]
Sin mapaccum el grafo tendría 160 × 10 × 4 evaluaciones del campo escritas una detrás
de otra. Con él, el cuerpo está una vez y el recorrido lo hace la máquina virtual de
MX. (La compilación JIT a C, que para grafos pequeños vuela, aquí no terminó en diez
minutos: se usa la máquina virtual.)
El coste y el NLP. Con la trayectoria ya montada, el coste son cuatro líneas y el gradiente, una:
Z = trayectoria(paso, ca.DM(z0), A)              # n_est x N
CM = ca.mtimes(S, Z[: 2 * p.n_o, :])             # centro del rebano, 2 x N
XT = ca.reshape(Z[: 2 * p.n_o, -1], 2, p.n_o)    # posiciones finales

llegar   = ca.sumsqr(media(XT) - obj) / L2
agrupar  = dispersion(XT) / D0
esfuerzo = ca.sumsqr(A) / (n * p.n_p * a_max ** 2)
seguir   = ca.sumsqr(CM - ca.repmat(obj, 1, n)) / (n * L2)

J = llegar + lam * agrupar + bet * esfuerzo + gam * seguir
gradJ = ca.Function("gradJ", [A], [ca.gradient(J, A)])
Y la llamada al solver, con las dos opciones que de verdad importan —L-BFGS, porque un hessiano de 960 × 960 por AD no es asumible, y el escalado apagado, porque lo hacemos a mano—:
nlp = {"x": ca.vec(u), "f": escala * J(u * a_max)}
solver = ca.nlpsol("ocp", "ipopt", nlp, {"ipopt": {
    "max_iter": 200, "tol": 1e-8,
    "hessian_approximation": "limited-memory",
    "limited_memory_max_history": 20,
    "nlp_scaling_method": "none",
    "mu_strategy": "adaptive",
}})
sol = solver(x0=ca.DM(A0.reshape(-1, 1, order="F") / a_max), lbx=-1.0, ubx=1.0)
El escalado no es cosmético. Tal cual, con controles del orden de 25, y IPOPT agota las iteraciones sin moverse del sitio. Hacen falta dos cosas, y las dos: que las incógnitas sean , y multiplicar el objetivo por un factor que deje el gradiente inicial en . Ese factor es la longitud del primer paso de L-BFGS, que arranca con el hessiano identidad. Con un factor 50 veces mayor, el primer paso saca los controles del rango útil y la solución cae en la cuenca equivocada: los perros se alejan hasta que su repulsión es despreciable. Un punto estacionario impecable y un resultado inútil.
La escalera de pruebas
Nada de lo de abajo se mira hasta que lo de arriba funciona. Es la misma disciplina del
artículo anterior, y aquí hace más falta todavía: un optimizador que devuelve
Solve_Succeeded no está diciendo que el resultado sea bueno, solo que ha encontrado un
punto estacionario de lo que le hayas escrito.
| Qué comprueba | Resultado | |
|---|---|---|
| 0 | el paso de RK4 no decide el resultado | con diverge; con , error 6·10⁻⁵ |
| 0b | la dinámica es la ya validada en LAMMPS | el centro del rebaño coincide con error del 0,05 % del recorrido |
| 1 | el gradiente por AD es correcto | 4,5·10⁻¹⁰ frente a diferencias finitas, y 18 veces más rápido |
| 2 | 1 perro + 1 oveja, como en Escobedo et al. | el perro se coloca detrás (cos = 0,999) a 42 unidades () y empuja |
| 3 | 20 ovejas + 1 perro | de 0,374 a 0,161; la dispersión final cae a la cuarta parte |
| 4 | 200 ovejas + 3 perros | la sección siguiente |
Dos peldaños merecen comentario.
El paso del integrador no se elige a ojo. Con y la integración no es imprecisa: diverge, a 10²³⁰ y más. El perro tiene una escala de tiempo de y RK4 no la aguanta con pasos largos. Con ya está cerca del límite (error 0,46 en el estado final) y con cae a 6·10⁻⁵. Diez subpasos por intervalo de control, por tanto, no son prudencia: son el mínimo.
El caso de un perro y una oveja da el resultado más instructivo de todos. Si el perro
empieza del lado equivocado —entre la oveja y el objetivo— y se arranca el
optimizador de control nulo, IPOPT converge, con todas las de la ley (Solve_Succeeded),
a la solución de abandonar: el perro se va lejos, su repulsión se anula, el gradiente
también, y la oveja se queda donde está. Arrancando de la heurística, que sabe rodear, el
mismo optimizador con el mismo coste encuentra la solución buena y lleva la oveja al
objetivo.
| 1 perro, 1 oveja | arranque | final | distancia final | llega en |
|---|---|---|---|---|
| perro detrás | frío | 0,087 | 0,6 | t = 37 |
| perro detrás | caliente | 0,087 | 0,6 | t = 37 |
| perro delante | frío | 1,599 | 186,1 | no llega |
| perro delante | caliente | 0,139 | 0,3 | t = 74 |
Dicho lo cual, conviene no generalizarlo, y este es justo el tipo de cosa que una escalera de pruebas sirve para desmentir: en el caso grande el arranque en caliente no hace falta. Repitiendo el problema de 200 ovejas partiendo de control nulo se llega al mismo sitio —distancia 2,2 en vez de 2,0, el mismo coste 0,130 y hasta un poco menos de esfuerzo—. Quien saca al optimizador del agujero allí no es la heurística: es el término de seguimiento, que le da gradiente desde el primer intervalo.
Qué sale
Las dos políticas, con la misma dinámica, el mismo estado inicial y la misma cota. Los paneles no son vídeos: el navegador reconstruye los 150 fotogramas de cada escena a partir de un binario y los dibuja en vivo. La barra va a cualquier instante y cada panel lleva debajo sus tres medidas.
- los tres perros
- 200 ovejas
- objetivo
| Al final del horizonte | heurística | óptimo |
|---|---|---|
| coste | 0,639 | 0,130 |
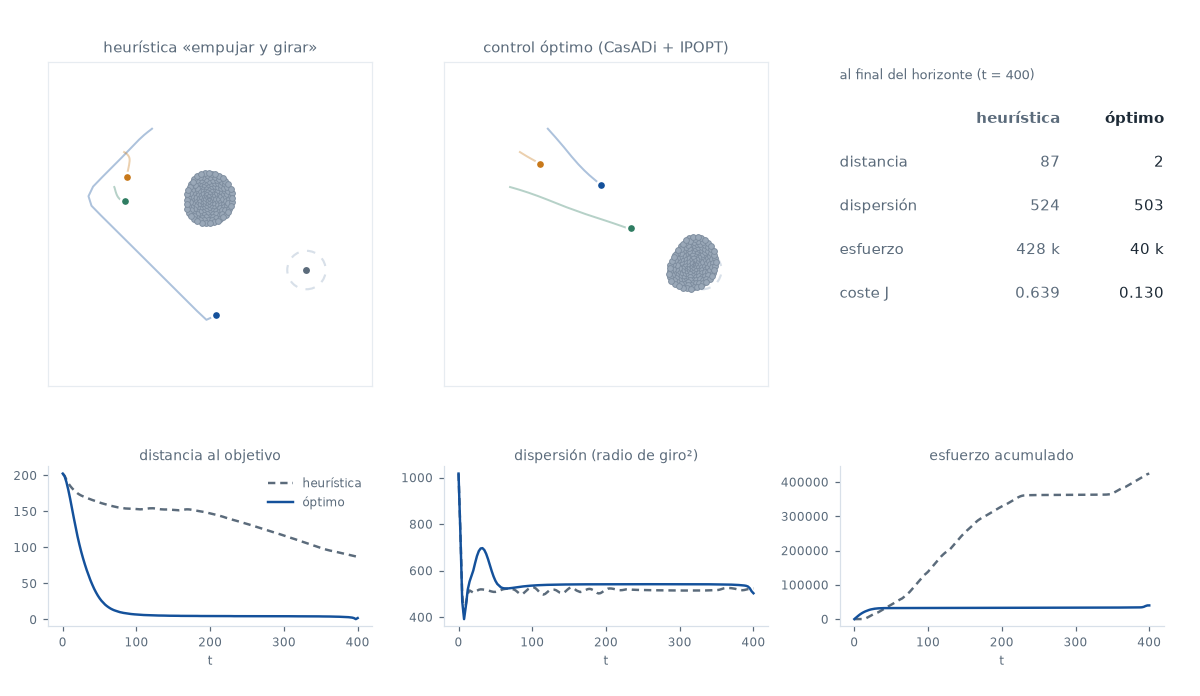
| distancia al objetivo | 86,9 | 2,0 |
| cuándo llega a menos de 20 | nunca | t = 60 |
| distancia mínima | 86,9 | 0,5 |
| dispersión (radio de giro²) | 524 | 503 |
| esfuerzo | 428 300 | 39 982 |
El óptimo no gana por poco: llega —la heurística, con 200 ovejas, ya no— y lo hace gastando diez veces menos. Y la diferencia se ve mejor en la animación que en la tabla: los perros de la heurística se pasan la mitad del tiempo rodeando el rebaño, porque su término de giro los manda a la línea exacta rebaño → objetivo y vuelve a mandarlos cada vez que el rebaño se desvía. Los perros del óptimo empujan en diagonal, aceptan que el rebaño no vaya recto, y corrigen al final.
Hay un detalle que dice mucho sobre qué es optimizar, y está en la curva del esfuerzo acumulado: el 81 % del gasto del óptimo ocurre en los primeros 50 de las 400 unidades de tiempo, que es cuando el rebaño pasa de 202 a 26 del objetivo. El resto del horizonte —350 unidades— solo sirve para recorrer esas últimas 26, con los perros prácticamente parados. La heurística hace lo contrario: su esfuerzo sube durante todo el horizonte, porque cada vuelta cuesta lo mismo que la anterior.
Lo que el coste te devuelve, al pie de la letra
Esta es la parte que de verdad se aprende escribiendo uno de estos problemas, y es la que no sale en la tabla de resultados.
El funcional pide dispersión pequeña al final. Eso es exactamente lo que el optimizador entrega, ni más ni menos: con 20 ovejas, la trayectoria óptima estira el rebaño en un arco que a mitad de camino alcanza una dispersión de unos 6 200 —diez veces la de partida; la heurística nunca pasa de 673— y lo recoge justo a tiempo para acabar en 164. Es correcto, cumple el coste al pie de la letra, y es desagradable de ver.
Con 200 ovejas no pasa, pero no porque el coste lo impida: la cohesión suma sobre todo el rebaño sin normalizar, así que con 200 individuos es siete veces más fuerte que con 30 y mantiene el grupo unido aunque nadie se lo pida. Es suerte, no diseño.
Lo que se arregla escribiendo lo que se quiere: añadiendo un peso sobre la dispersión a lo largo del horizonte, el rebaño se mantiene compacto todo el camino y encima acaba más cerca, a cambio de un 80 % más de esfuerzo.
| Variante | distancia final | dispersión final | esfuerzo | tiempo | |
|---|---|---|---|---|---|
| heurística | la política del TFM | 86,9 | 524 | 428 300 | 2 s |
| el del enunciado | , , , arranque caliente | 2,0 | 503 | 39 982 | 105 min |
| arranque frío | el mismo coste, partiendo de control nulo | 2,2 | 503 | 37 420 | 105 min |
| sin seguimiento | : el coste solo mira el instante final | 3,1 | 514 | 120 377 | 126 min |
| más peso a agrupar | 1,7 | 333 | 57 601 | 117 min | |
| compacto todo el camino | : la dispersión cuenta en cada instante | 1,4 | 369 | 68 956 | 116 min |
Las cinco versiones del óptimo hacen lo mismo a grandes rasgos —empujar en diagonal y llegar pronto—; lo que compran los pesos altos es un rebaño más apretado, y lo pagan en esfuerzo. Cada una de esas filas son dos horas de IPOPT, que es la otra mitad de la moraleja: explorar el espacio de los pesos es caro, así que conviene saber qué se está pidiendo antes de pedirlo.
Qué no demuestra esto
Cinco límites, por orden de importancia:
No converge. IPOPT para en el máximo de iteraciones con la infactibilidad dual en 3,6·10⁻⁴, no en la tolerancia pedida. El grueso de la mejora está en las primeras 40 iteraciones y las últimas decenas apenas mueven el coste, así que para el resultado da igual; pero esto no es un óptimo global, ni siquiera un mínimo local certificado: es el mejor punto que IPOPT alcanzó en 105 minutos. Todo lo que dice el artículo es que ese punto es mucho mejor que la heurística.
Es lazo abierto. Una trayectoria de control calculada de antemano para un estado inicial concreto. Si una oveja se desvía, nadie corrige; si el estado inicial cambia, hay que volver a pagar las dos horas. La versión honesta sería MPC —reoptimizar cada pocos pasos sobre un horizonte corto—, que es justamente lo que hacen Ko y Zuazua con random batch, y es el motivo por el que el TFM se fue al aprendizaje por refuerzo: una política aprendida responde en microsegundos a cualquier estado.
Una condición inicial, y benévola. Los tres perros arrancan ya por detrás del rebaño. El peldaño 2 enseña lo que pasa cuando no es así —con un perro delante y arranque frío, el optimizador converge a abandonar—, pero esa variante no está corrida en el caso grande. Y el reparto inicial de las ovejas es una espiral de Fibonacci con un poco de ruido, no un sorteo uniforme: con 200 ovejas al azar quedan parejas pegadas, y una pareja pegada hace que la fuerza domine el primer instante.
La comparación favorece al óptimo en el terreno que mide el coste. Con 200 ovejas el óptimo gana en todo, pero en el peldaño de 20 ovejas y un perro gasta más: 49 956 de esfuerzo frente a 2 059 de la heurística, para acabar a 8,6 en vez de a 5,0 —con la dispersión final a la cuarta parte, que es lo que el coste le pide y la heurística no hace—. Comparar políticas con un número exige decir cuál, y aquí el número es con unos pesos concretos.
El modelo sigue siendo un modelo. Ovejas que son puntos sin visión, sin ruido y sin terreno, repulsión isótropa, cohesión de alcance largo y sin normalizar —de modo que las fuerzas crecen con el tamaño del rebaño—. Lo que se defiende aquí es la cadena numérica: la dinámica es la misma que se validó en LAMMPS (0,05 % de desvío en el centro del rebaño), el gradiente es correcto (4,5·10⁻¹⁰) y el paso del integrador está elegido, no heredado.
La segunda parte: rebaños que no son un disco
Todo lo de aquí empieza con 200 ovejas repartidas en un disco, que es el caso fácil: un rebaño compacto tiene un centro que lo representa, y por eso una política que solo mira el centro —la heurística— puede funcionar. La pregunta siguiente es qué pasa cuando no lo es: un rebaño en forma de media luna, partido en dos grupos, o repartido a lo largo de una línea.
Ahí el centro de masas deja de ser una descripción útil —puede caer en un sitio donde no hay ninguna oveja— y la heurística pierde la poca información con la que trabajaba. El control óptimo, en cambio, no necesita que el rebaño tenga forma de nada: ve las 200 posiciones.
El escenario ya está escrito en el repo (--escenario irregular): una banda curva con
dos grumos densos unidos por un puente ralo, y los tres perros repartidos a mala idea
—uno dentro del grumo grande, otro al otro lado de la banda y el tercero entre el
rebaño y el objetivo, es decir, justo donde más estorba—.
Eso es Un rebaño que no es un disco, la segunda parte: allí la heurística no mueve el rebaño en absoluto —se queda a 264,5 del objetivo, donde empezó— y el optimizador lo reúne, lo estira para arrastrarlo y lo deja dentro gastando una quinta parte. Con dos lecciones de calibración que no se ven venir y tres horas y media de IPOPT que acaban mucho más lejos de converger que estas.
Cómo reproducirlo
Todo está en github.com/djoroya/sim-visuales,
en control/pastoreo-optimo/. Un solo script:
./run.sh              # todo (el caso grande tarda ~2 h)
./run.sh escalera     # solo las comprobaciones (~5 min)
./run.sh grande       # solo el problema de 200 ovejas y 3 perros
./run.sh salidas      # binario del visor, poster e informe
Hace falta Python 3 con CasADi, numpy y matplotlib —el script crea el entorno virtual la primera vez— y, opcionalmente, LAMMPS para el contraste del peldaño 0b. La escalera entera son cinco minutos; el caso grande, las dos horas de IPOPT de la tabla.
Lo más instructivo que se puede hacer con él es tocar los pesos: --lam, --bet,
--gam, --lam-t. Cada ejecución tarda lo suyo, pero la lección llega antes de que
acabe.
Detalle técnicoCómo caben las dos simulaciones en esta página
Cada escena son 150 fotogramas de 203 individuos, y hay dos. En disco eso son varios megabytes de texto; lo que llega al navegador son 238 KiB sin comprimir y 174 con gzip, con el mismo truco que el artículo anterior: posiciones cuantizadas a 16 bits sobre la caja común, con el byte alto y el byte bajo en planos separados para que gzip tenga algo que morder. El error de reconstrucción es de 0,003 unidades de longitud, tres órdenes de magnitud por debajo del radio con el que se dibuja una oveja.
Es seis veces y media lo que pesaba la trayectoria del artículo anterior, y buena parte de la culpa es que son dos trayectorias: el lado a lado se paga entero. A cambio, el visor sigue siendo un canvas 2D sin dependencias —son 203 círculos por panel— y la página no descarga nada de esto hasta que la figura está a 300 px de entrar en pantalla. Lo que se ve antes, y lo único que se ve sin JavaScript, son los dos pósters PNG (14 y 9 KiB), que los genera un script a partir del propio binario, con la misma paleta y los mismos radios que el visor y en el mismo instante en el que el visor se queda parado si has pedido menos movimiento. Así, al montarse, no se mueve nada.
Referencias. J. Oroya, Aprendizaje por refuerzo aplicado al problema del pastoreo, TFM, Máster en Ingeniería Computacional y Sistemas Inteligentes, UPV/EHU, 2020; director: Roberto Santana — modelo, parámetros y heurística; está en la página de artículos con su PDF. · R. Escobedo, A. Ibáñez, E. Zuazua, Optimal strategies for driving a mobile agent in a “guidance by repulsion” model, Commun. Nonlinear Sci. Numer. Simul. 39 (2016) 58–72 (arXiv:1509.05008) — el caso de dos agentes del peldaño 2. · D. Ko, E. Zuazua, Asymptotic behavior and control of a “guidance by repulsion” model (arXiv:1911.01133) y Model predictive control with random batch methods for a guiding problem (arXiv:2004.14834) — el lazo cerrado que aquí no está. · J. Andersson et al., CasADi: a software framework for nonlinear optimization and optimal control, Math. Prog. Comp. 11 (2019) 1–36. · Código original en MATLAB, de la Cátedra de Matemática Computacional de Deusto: DeustoTech/GuidanceByRepulsion.